
如果今天只是要辨識一張乾淨的 A4 文件,我大概不會想自己做 OCR。
市面上已經有非常多成熟的 OCR 工具,開源、商用、雲端 API 都有。丟一張圖片進去,把文字抓出來,這件事情本身早就不是什麼新技術。
但當我要處理的東西變成台灣政府公文之後,事情就開始不太一樣了。
這也是我開始這個專案的原因。
接下來 30 天,我想把這段研發過程完整拆開來寫。
不是只介紹「怎麼 Fine-tune 一個 OCR 模型」,而是從資料、文字偵測、版面分析、VLM 辨識,一路寫到 GPU 記憶體、多人併發,甚至包含一些最後被我放棄的技術方案。
這篇先從最前面的問題開始:
為什麼我不直接用現成 OCR?
一開始接觸這個問題時,很容易把它想成:
PDF → OCR → 文字
但真的把政府文件丟進系統後,我很快發現,「把字讀出來」其實只是問題的一部分。
我目前處理的語料包含:
這些文件都有一個共同點:
它們是設計給人看的,不是設計給 OCR 看的。
對人來說,我們看到一張表格,很自然就知道哪個數字屬於哪一欄;看到直排欄位,也知道閱讀方向要換。
但對程式來說,它看到的其實只是一堆 pixel。
而在實際整理資料的過程中,我把最常遇到的問題歸納成四類。
這個系統主要面對的是繁體中文。
除了常見中文字之外,政府文件裡還會出現:
如果只是一般文章,偶爾錯一個字可能還能接受。
但如果 OCR 的結果後面還要拿去做:
那一個字的錯誤就可能不只是 typo。
例如金額、案號、法條名稱辨識錯誤,後面的 AI 即使再聰明,拿到的 source 本身就是錯的。
所以我真正想知道的,不是:
「這個模型看起來會不會讀中文?」
而是:
能不能真的把錯誤率壓到一個可以進入後續資訊系統的程度?
這也變成我後來第一個研究問題:
能不能做到平均每 1,000 個字,錯不到 10 個字?
換成 OCR 常用的指標,就是:
CER(Character Error Rate)能不能低於 1%?
CER 到底怎麼算,以及為什麼只看「準確率 99%」其實很危險,我會留到後面的 Benchmark 篇再談。
這是一般文章型 OCR 很容易忽略的地方。
政府文件裡可能同一頁同時出現:
正文是橫書,表格欄位卻是直書。
例如預算表、統計表、分類欄位,為了節省水平空間,標題很常被轉成直排。
對人類來說只是把頭稍微歪一下。
但對 OCR 來說:
「這是一串由左到右的文字?」
還是:
「這是一串由上到下的文字?」
是兩個完全不同的問題。
因此我最後並沒有嘗試讓一個辨識流程硬吃全部內容,而是開始把不同型態的文字分流處理。
這也是後面整套架構會逐漸變複雜的第一個原因。
如果只拿一般文章測 OCR,很容易得到一個非常漂亮的數字。
但真正的公文不是只有文章。
裡面可能會出現:
這時候問題已經不只是:
「這裡寫了什麼?」
而是:
「這段文字到底屬於哪一格?」
假設 OCR 把整張表裡的字全部認對,但是欄位位置全部亂掉,對後面的程式而言,那張表基本上還是不能用。
因此我要保留的不只是文字。
最後希望輸出的其實是:
文字 + 版面座標 + 表格結構
從這裡開始,這個問題就已經慢慢從「OCR」變成「Document Understanding」。
政府文件很常見的另一種情況是:
多欄 + 圖片 + 表格 + Header/Footer + 正文全部混在一起。
如果只是偵測出所有文字框,還是不夠。
系統還要知道:
否則就會發生另一種很典型的問題:
每個字都認對了,但組回來的文章順序是錯的。
所以後來我開始把「文字在哪裡」、「這塊東西是什麼」、「這個字怎麼讀」拆成不同問題。
而不是期待一個模型從頭包到尾。
除了技術條件之外,這個專案還有一個實際限制:
排除中國大陸來源的辨識引擎。
也就是說,技術選型不能只看排行榜上誰最準。
模型來源、授權、能不能自己部署、GPU 資源、後續能不能維護,都要一起考慮。
這也是為什麼最後這套系統沒有變成:
「找一個 Benchmark 第一名的 OCR,裝起來,結案。」
而是慢慢長成一套自己的 Pipeline。
這大概是這個系列最重要的觀念之一。
我原本以為我要解的是:
圖片 → OCR Model → 文字
最後實際做出來的東西比較接近:
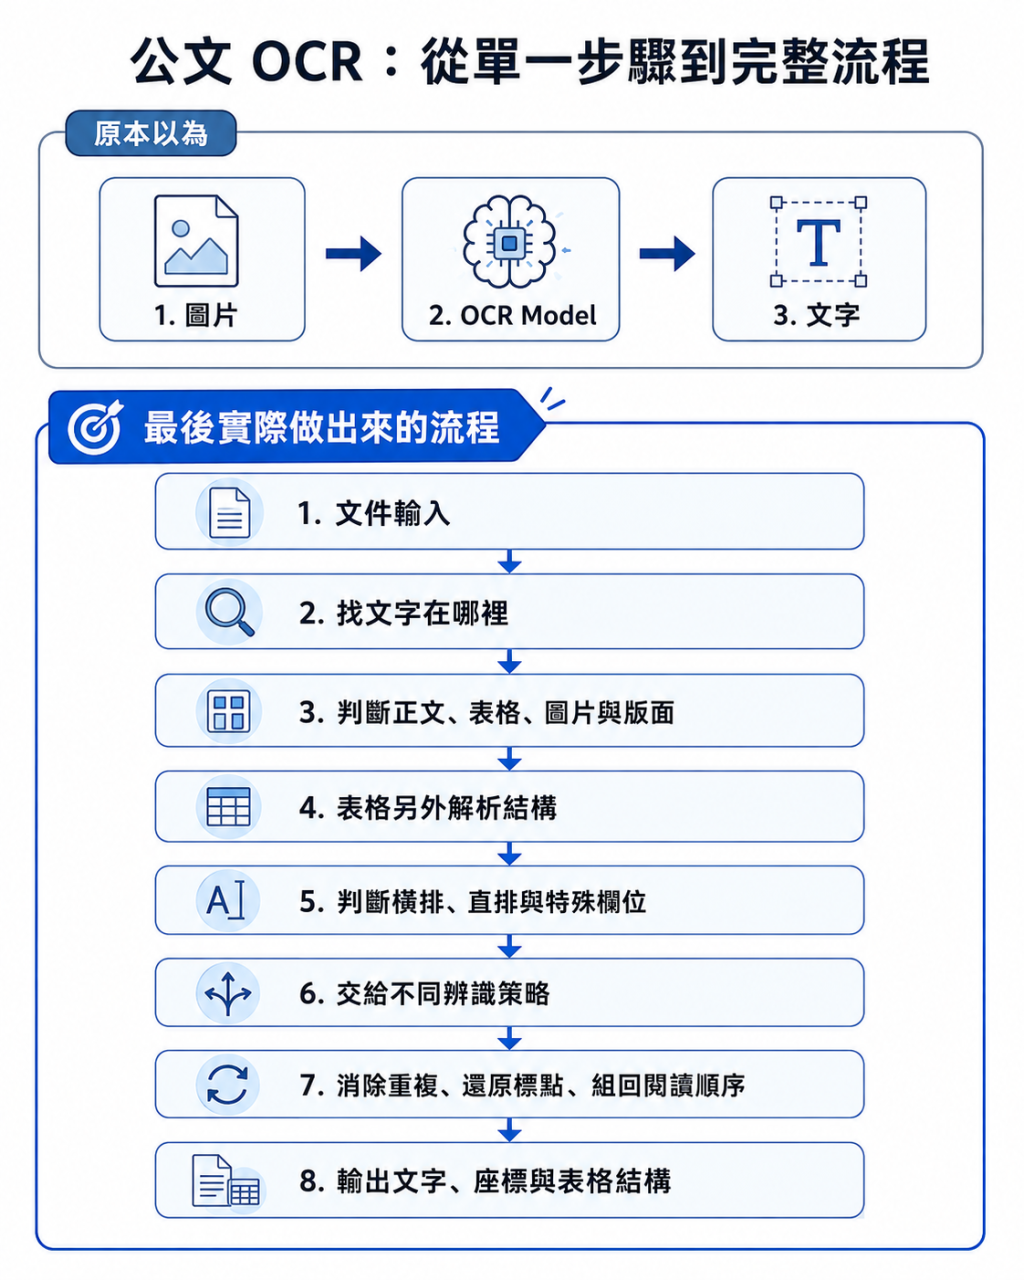
目前整套流程實際包含了 CRAFT、Heron、PaliGemma2,以及不同用途的 LoRA。
但這些名稱今天先不用記。
後面我會一層一層拆。
做到後來,我把整個研究整理成六個很實際的問題:
有些答案跟我原本想的一樣。
有些完全相反。
尤其是最後一題。
我一開始非常看好 vLLM。
最後卻把它拿掉了。
這部分後面會寫。
這系列不會只是一套「安裝 OCR 套件教學」。
我比較想記錄的是:
一個 OCR 系統到底怎麼從「模型跑得動」,一路做到「真的可以放進服務裡」。
會包含:
資料怎麼做、Benchmark 怎麼設計、LoRA 怎麼訓練、為什麼有一次模型看似收斂其實根本沒看完資料、怎麼把 GPU 記憶體砍下來、怎麼測多人併發,以及那些花了很多時間最後卻證明不值得採用的方案。
目前這個專案仍在持續進行。
所以這 30 天與其說是一份「成功案例教學」,我更希望它像是一份工程紀錄:
做了什麼、為什麼做、量到了什麼,以及哪些結論其實還不能下。
今天先不碰模型。
如果只留下一件事情,我希望是這句:
真實世界的 OCR,問題通常不是「模型會不會認字」,而是你到底要讓它讀什麼樣的文件。
繁體中文、直書、表格、多欄版面、閱讀順序……
當這些條件全部疊在一起後,我需要解的已經不是單純的文字辨識問題。
而是一整套文件理解流程。
明天 Day 2,我會先談一件我後來覺得比選模型更重要的事情:
如果模型號稱 99% 準確率,那真的代表 1000 個字只會錯 10 個嗎?
以及一個在自己的測試集非常漂亮的分數,為什麼到了真正沒看過的公文上,可能完全不是那回事。


 iThome鐵人賽
 看影片追技術